11月4日,乌镇世界互联网大会发布的《中国互联网发展报告2026》提到:人工智能已被正式纳入国家网络安全法律体系——修改后的《网络安全法》新增第二十条,对人工智能安全与发展作出专门规定;截至今年8月底,累计1112款生成式人工智能服务完成备案,731款生成式人工智能应用或功能完成登记。
一套“人工智能可以被约束、被追溯、被追责”的制度框架正在加速建立,面临制度框架的真正落地,供给侧必须先回答一个前置问题——人工智能给出的结论,凭什么被采信?可靠性、准确度又如何被验证及评估?
演示惊艳、上线打折,断在哪
过去两年,产业界见过太多“演示惊艳、上线打折”的项目。麦肯锡曾针对企业CTO做过一项调研,约70%的数字化项目因技术适配性不足或需求错位未能达成预期目标。以国双多年数智落地的经验来看,问题往往出在三个断点:
数据不真实。合成数据、实验室数据、口径不一的存量数据,在演示环境里都够用,一旦进入真实工况就开始漂移。
知识缺位。通用模型不了解行业的约束边界,能输出逻辑流畅、但在物理上荒谬的结论——而且错得很有说服力,非专业人士根本看不出来。
无人担责。结果无法复核、错误无法定位,出了问题说不清是数据错、规则错还是模型错,最后往往要么整体弃用、要么暂停搁置。
三个断点的共同点是:它们其实都不是“模型不够强”造成的,而是“证据链不完整”造成的。
国双认为:数据是原料,证据则是经过验证、因果闭合、能够支撑一次决策判断的数据。前者可以用来演示,后者才能上产线。
高效构建“可信度”的三层地基
基于这个判断,国双把产业智能的可信度拆成三层地基:
第一层,数据靠得住——解决“事实是否可信”
三个金标准:来自真实物理世界,可回溯,覆盖工况边界。缺一条,模型就只会在演示集上表现良好。
第二层,知识与规则——解决“推理是否可解释”
在可靠数据之上,用知识工程把行业机理、工艺边界、因果关系结构化,约束模型的解空间,让它不越出物理和业务允许的范围。这一层的价值在于:它把“看起来合理的输出”变成“有依据的推理”。
第三层,专家在环——解决“责任是否可担”。
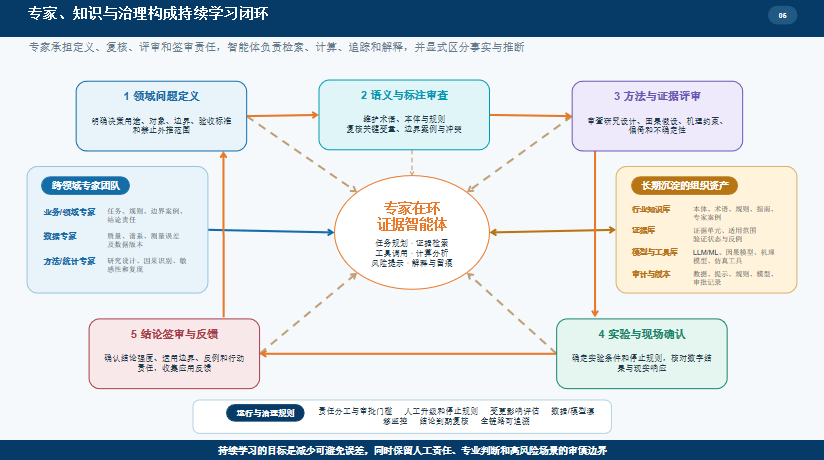
专家不是“陪着看”,而是在关键节点上有裁决权。在国双的领域证据链架构里,这样的专家关口有四个:口径定义与边界裁决、低置信与冲突样本裁决、金标准与复核裁决、结论签发与责任承担。
三层合起来,证据链才能够闭合:数据可回溯→知识有出处→专家可确认。
落到工程上的“七段流水线”
三层地基是“可信度从哪里来”,落到实际交付,国双认为这是一条“七段流水线”:
业务领域(定义场景、决策与责任边界)
数据描述(可定位的数据底座)
业务语义(机器可理解的业务世界)
证据生产(带溯源的证据单元)
验证校准(可信证据集与质量报告)
可信证据(可复用的证据资产)
推理与结论(可信结论与决策建议)
最终由“结论回写业务、反馈进入评测集、持续校准”形成闭环,整条链路则由“行业知识底座”“专家经验网络”“治理与合规约束”三层能力横贯支撑。
国双认为是真正拉开差距的,是来自于:
一要把“证据”做成独立的资产层
要给人工智能的结论构建一套会计制度:它不再是一个答案,而是一组可以被追溯、被复用、被审计的资产,这是“可信”和“看起来可信”之间的明确分界。
二是专家介入位置要被明确定位
谁裁决、裁决什么、担什么责任,都需要清晰可查,泛泛而谈的“专家参与”,很难从根本上夯实效果评估。
三是可信度累积不能简单二元判断
智能是否可信,其判断结论其实不该被简单分成“能用”和“不能用”,产业客户做决策时真正需要的颗粒度更细,且应该被提前明确。
未来可见,随着人工智能立法推进和沙盒机制铺开,“可解释、可追溯、可追责”会逐步从加分项变成准入门槛,规模化入场券不属于模型最大的企业,将属于证据链最完整的企业。
为此国双的答案也很朴素:以“数据”为地基,以“证据”为标准,用知识工程把行业机理结构化,用专家在环守住每一次结论签发——让产业智能不只是一个聪明的系统,而是一件可以被信任的事。国双将继续与产业伙伴及企业客户携手,坚持从可靠性、可用性以及准确度出发,提供可切实提高产业新质生产力的务实智能方案。
有富策略配资提示:文章来自网络,不代表本站观点。